
기획 배경
19개월째 프로젝트를 이어오면서 팀 내 의사결정이나 회의 과정에서 지속적으로 발생하는 문제가 보이기 시작했다. 가장 대표적인 문제는 두 가지였다.
첫 번째는, 회의 중에 과거 회의 내용을 기억하지 못해 문제가 생기는 경우가 많아졌다는 것이다. 약 70회차가 넘는 회의록이 쌓이다 보니 팀원들 내부에서도 과거 의사 결정 내용을 기억하지 못하는 경우가 종종 발생한다. 이런 경우 다른 팀원들의 기억에 의존해야하다보니 회의 진행에 병목이 발생한다.
두 번째로는, 추측성 의사 결정 문제이다. 시간이 많이 흐를수록 회의 내용은 과거의 내용을 전제로 생성된다. 그런데 과거 내용에 대한 사실 여부를 확인하기도 어렵고 회의 내용이 회차를 거듭하면서 변형되기 때문에 잘못된 시점의 내용으로 기억하고 있다면 다음 의사 결정에 잘못된 근거가 반영되어버린다.
이러한 두 가지 문제를 해결하기 위해 우리 서비스의 지식을 배경으로 하는 LLM이 필요하다고 판단되었고, 이에 노션을 대상으로 RAG를 붙여 모꼬지 개발자 전용 LLM을 개발하게되었다. 마침 SSAFY에서 로컬 LLM의 사용과 RAG에 대해서 배우고 있던 참이라 이걸 팀 프로젝트에 적용시켜보기로 하였다.
목표 상태
가장 기초적으로 목표하는 상태는 다음과 같다.
          사용자 질문
                     ↓
         관련 문서 검색
                     ↓
검색된 문서를 Context로 사용
                     ↓
     로컬 LLM이 답변 생성
예를 들면,
Q. 카카오 auth로 최초 가입한 사용자의 초기 role은?

A. 최초 가입 사용자의 초기 role은 NORMAL입니다. + 첨부 문서
이런식으로 모꼬지라는 프로젝트만의 LLM을 구성해 자유롭게 사용할 수 있도록 구성하는 것이 목표이다.
이 구성을 위해서는 내부 문서를 Context로 찾아 붙여줄 RAG 시스템이 필요하고, 우선적으로 ‘동작이 가능한’ RAG를 붙이는 것을 목표로 하였다.
기초
RAG를 사용한 로컬 LLM이라는 하나의 파이프라인을 구성하기 위해선 우선 몇 가지 개념을 알아야한다.
- RAG와 LLM은 별도의 구성이다.
가장 처음으로 헷갈릴법한 부분이 둘의 관계인데, llm은 질문에 답변하기 위한 모델이고, RAG는 질문에 대한 대답을 준비하는데 참고할 자료를 찾기 위한 도구이다. - RAG의 구성
RAG의 파이프라인은 다음과 같다.
대상 문서 파싱(읽을 수 있는 일관된 형태로 변환) → 적절한 단위로 청킹 → 청크 단위 임베딩 → 임베딩된 문서 인덱싱 → 질문 쿼리 임베딩 → 유사도 기반 검색 → LLM에 관련 문서 첨부
구성하기
생성 모델
우리는 우선 심화적인 활용법을 고려하지 않고 기본적인 질문 사용을 위한 개발을 고려하였기 때문에 비용도 고려하기로 하였다.
우선 LLM 모델을 선택하기 전에 모델을 띄워둘 서버를 탐색하였다.
조건은 다음과 같았다.
- 24시간 상시로 띄워둘 수 있는 서버일 것.
- 어느정도의 모델(7B)가 실행될 수 있는 환경일 것.
- 학생 팀 프로젝트이기에 비용이 저렴하거나 무료일 것.
이러한 조건에 부합하기 위해 찾아보다 Oracle 클라우드 컴퓨팅 서비스를 사용하기로 결정하였다.
간단한 작업이라도 그 내용의 정확도가 어느정도 보장되어야하고, 동시에 13B급 이상보다 메모리 사용량이 적기에 모델은 7~8B급을 사용할 것이고, 그 외에 임베딩 모델이나 FastAPI 등이 같이 올라가야 하기에 충분한 RAM 용량이 중요했다.
때문에 Oracle Cloud에서 RAM을 많이 확보할 수 있는 무료자원인 ARM기반의 2 OCPU / 12GB RAM 서버를 선택하게 되었다.
인스턴스를 생성했으니 이제 해당 리눅스 서버에 Ollama를 설치해야한다.
여기서도 착각할 수 있는 것은, Ollama는 LLM모델이 아니다.
Ollama는 모델을 다운로드하고 로컬에서 실행해주는 환경, 즉 런타임에 해당한다.
# Ollama 설치
curl -fsSL https://ollama.com/install.sh | sh

# 설치 버전 확인
ollama --version

# 생성용 모델 다운
ollama pull llama3.1:8b

# 로컬 모델 확인
ollama list
설치가 끝났다면 다음 명령어를 통해 LLM이 정상적으로 동작하는지 확인한다.
# 입력 후 아무거나 질문
ollama run llama3.1:8b
임베딩 모델
이제 문서를 임베딩 해줄 모델을 설치한다.
# nomic-embed-text 모델 사용
ollama pull nomic-embed-text
임베딩 모델을 간략하게 설명하면, 자연어로 들어온 입력을 쉽게 의미를 파악하고 찾을 수 있도록 벡터로 바꾸는 모델이다.
내일은 추석입니다. -> [0.124, -0.152, ...]
이 두 가지가 설정되었다면, 이제 RAG의 파이프라인을 구성하면 된다.
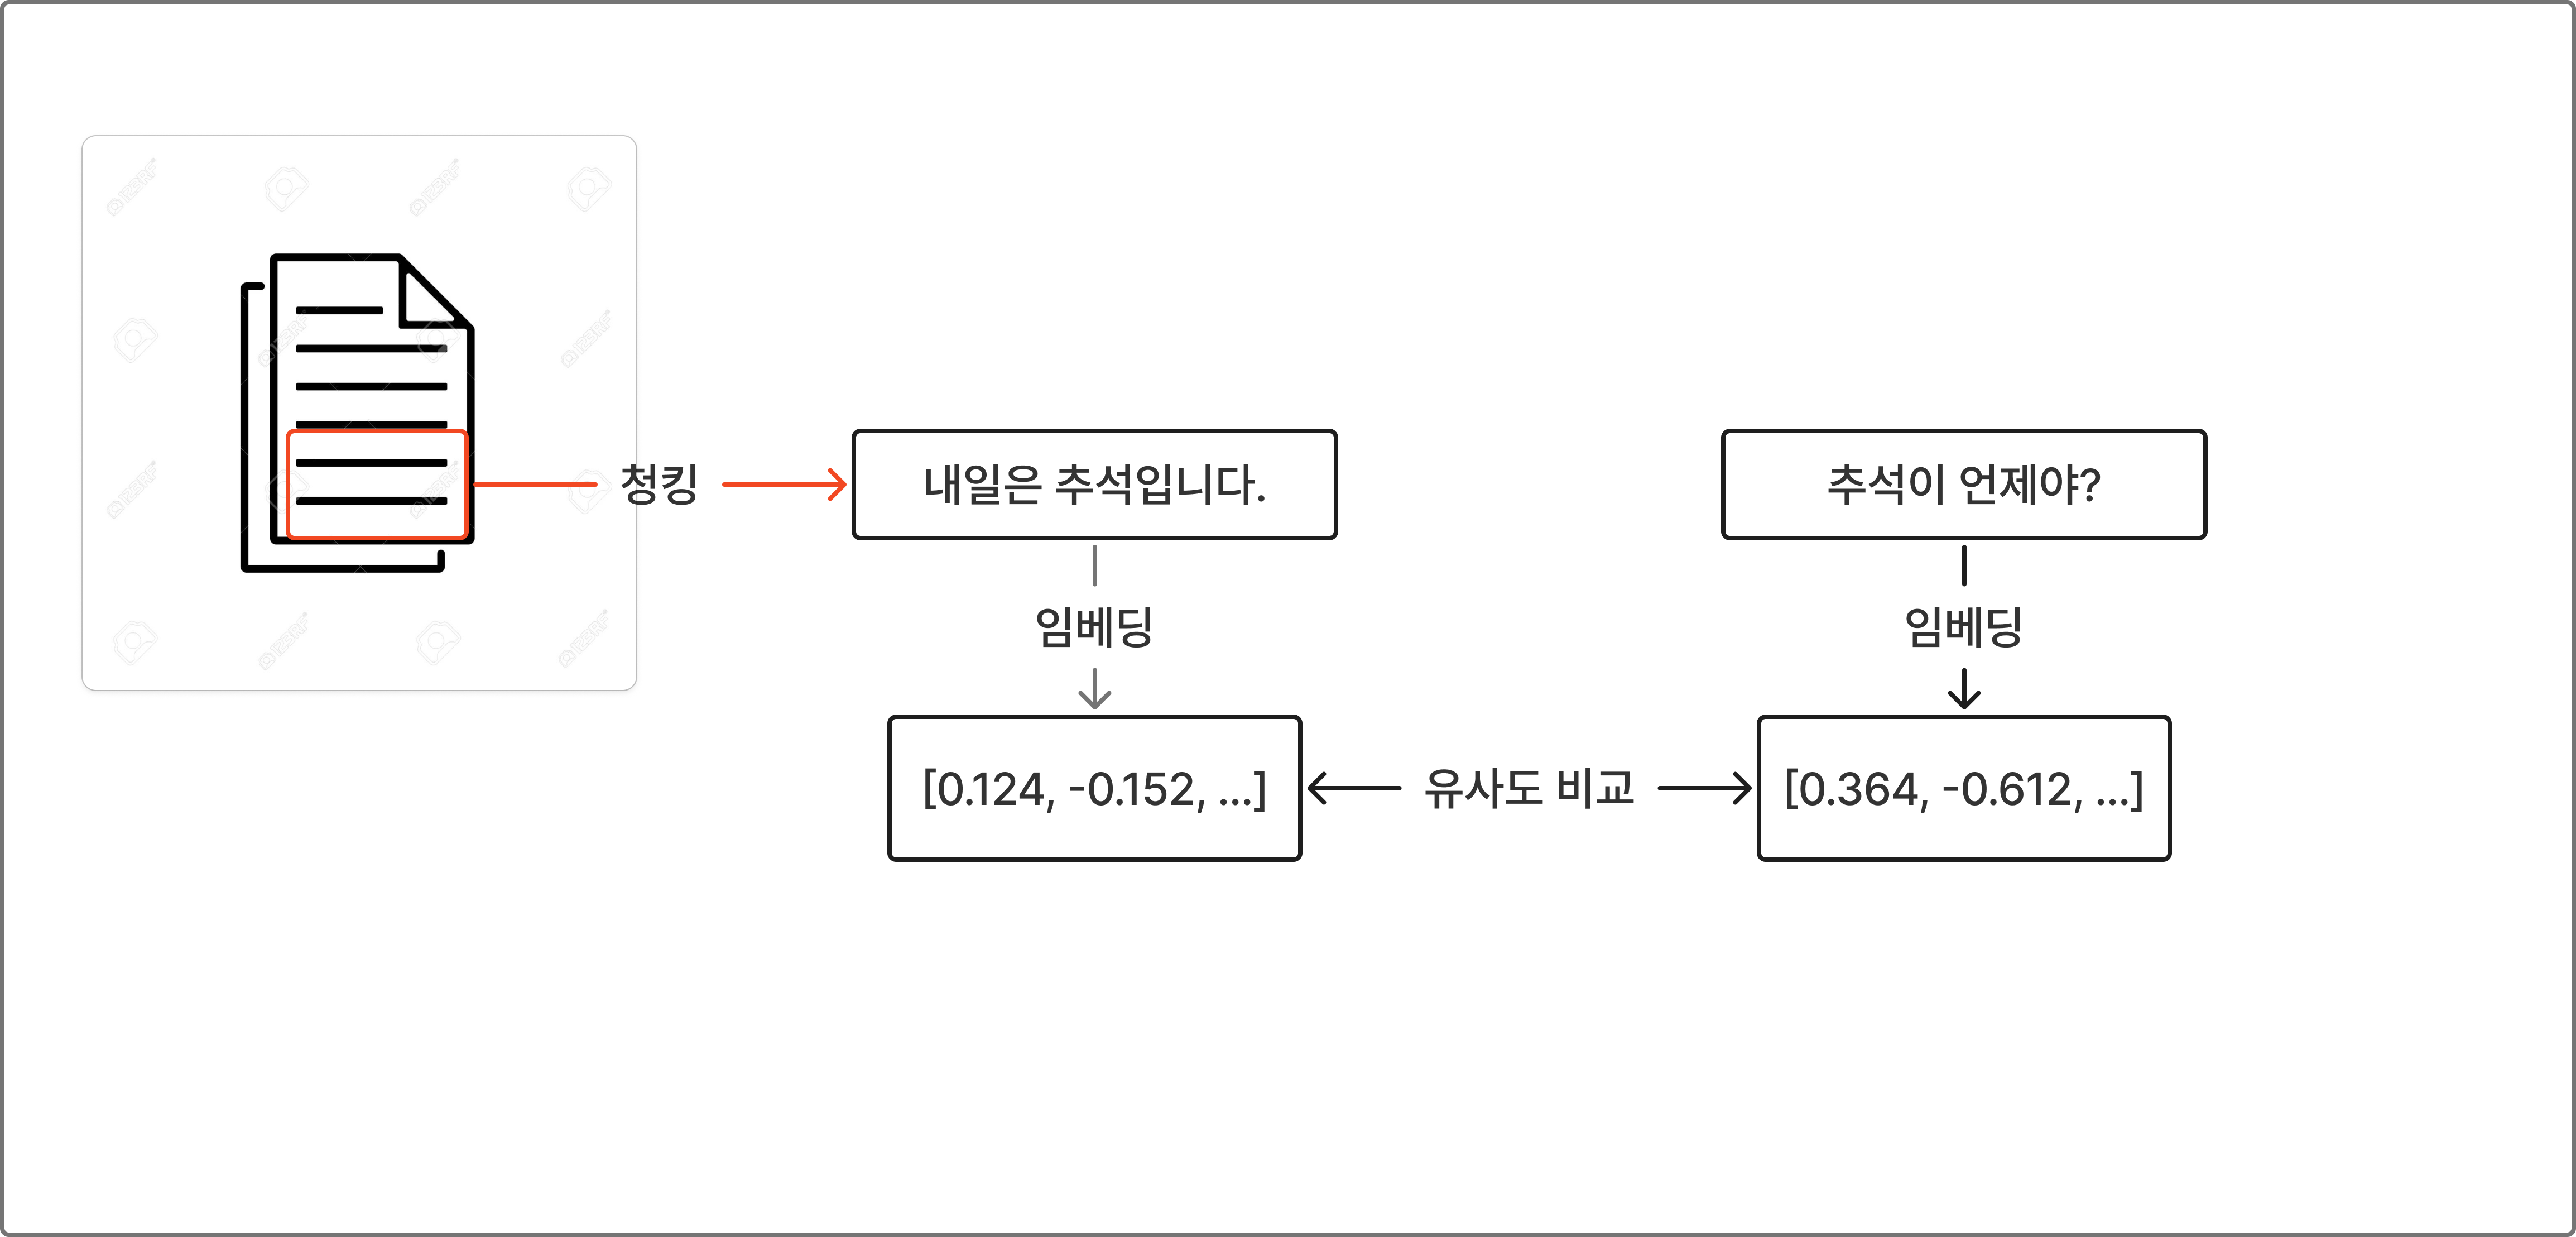
위에서 보이듯 가진 문서의 처리와 질문의 처리, 두 개의 축으로 분리해 볼 수 있다.
청킹
먼저 문서 처리를 보면 문서의 일부를 떼어오는 것을 알 수 있다.
보통 RAG를 사용하는 이유 중 하나는 문서의 크기가 크기 때문에 이를 특정한 방법으로 처리하여 빠르게 검색하기 위함이다. 여기서 특정한 방법에 ‘청킹’이라는 개념이 존재한다.
청킹, 그러니까 문서를 단위로 나누는 작업을 하는 이유를 설명하기 위해선 바로 뒤에 설명할 임베딩부터 이해해야하는데, 간단히 말하자면 주어진 문서의 의미를 벡터 값으로 치환하는 행위이다.
문제는 여기서 발생하는데, 너무 큰 단위로 청킹을 하게 되면 그 의미가 포괄적으로 묶이는 문제가 있다. 그렇게 되면 A라는 내용을 검색했을 때, A이상의 정보까지 흘러들어오게 되면서 정확도가 떨어지는 상황이 발생하게 된다. 그렇다고 단위를 너무 작게 하면 충분한 컨텍스트가 잡히지 않는 문제가 발생한다. 그렇기에 이 문제를 개선하기 위해서 각 팀의 문서에 맞게 적절한 단위로 청킹하는 작업이 필요하다.
청킹은 여러 단위로 진행할 수 있는데, 여기서 우리는 노션의 페이지를 청킹하기에 블록 단위로 청킹하는 것을 선택했다. 또한, 청크 끝과 끝에서 문장이 잘리는 것을 보완하기 위해 약 50자의 패딩을 주었다.
임베딩
RAG의 가장 중요한 개념이라고도 할 수 있는데, 앞서 말한 것처럼 임베딩은 문서의 자연어를 AI가 이해하고 쉽게 검색할 수 있게 벡터 값의 집합으로 치환하는 작업이다. 아무리 청킹을 잘해두어도 그 의미를 빠르게 파악할 수 없다면, 그저 조각조각 잘 분리된 일반 문서에 불과한다. 효율 좋은 작업을 위해선 AI가 읽을 수 있도록 의미를 미리 치환해두어야한다.
물론 문서의 내용을 벡터로 치환한 것 만으로는 검색이 용이해지지는 않는다. 데이터베이스에서도 특정 데이터를 찾기 위해서 인덱싱 작업을 하듯이, 임베딩된 데이터들도 벡터 인덱스를 생성해주어야한다. 여기에서는 LlamaIndex를 이용해서 아래와 같은 형태로 사용한다.
index = VectorStoreIndex.from_documents(documents)
사실 여기까지 하면 기본적인 RAG 문서는 준비가 되었다.
준비된 벡터 인덱스를 이용해 자료를 찾아낼 수만 있다면 내부 자료를 빠르게 가져다 사용할 수 있을 것이다.
다만 이제 질문을 하게 된다면 이 질문과 준비된 자료의 인덱스를 어떻게 비교할 것인가가 문제로 남는다.
그렇다면 질문도 벡터로 바꾸면 되지 않을까 싶은데, 이왕이면 정확한 검색을 위해서 임베딩 모델을 일치시키는 것이 좋다.
여기에서는 ‘nomic-embed-text’를 사용했으니 질문 임베딩도 같은 모델을 사용하였다.
다만 질문의 벡터 값과 문서의 벡터값이 완전히 일치할 수는 없다.
어쩌면 당연한 이야기인데, 문서의 내용을 통틀어 하나의 인덱스로 치환한 벡터 값과 질문의 벡터 값이 일치하려면 자연어로 작성된 문서와 질문이 완전히 일치해야한다.
이게 가능하다면 그건 더이상 검색이 아닐 것이다. 그럼 어떻게 해야하느냐? 답은 유사도 검색에 있다.
완전한 방법은 아니라고 생각하지만, ‘의미상 비교’라는 점을 고려하면 최선의 방법이라고도 생각한다.
여기서는 코사인 유사도를 사용했는데,
유사도 = 질문벡터 * 문서벡터 / ∣질문벡터∣×∣문서벡터∣이러한 식으로 계산된다.
여기서 나온 결과 값이 1에 가까울 수록 유사하고, 0에 가까울 수록 유사하지 않다.
말그대로 ‘유사도’이기 때문에 어느 정도의 값이 적절한지에 대한 답이 정해져있지 않다. 그래서 우리는 팀 프로젝트의 여러 문서로 테스트 해보며 가장 적절하다고 판단되는 유사도를 선택하였다.
이상한 테스트 결과?
여기까지 진행하면 이제 LLM을 통해 질문하면 해당 RAG를 이용해 특정 유사도 이상인 문서를 첨부해줄 수 있게 된다.
이론적으로는 문제가 없다고 생각해서 여러가지 테스트를 돌려보던 과정에서 이상한 점을 발견했다.
분명히 정상적으로 동작하고 제대로 잘 대답하기도 했지만, 몇몇 질문에서는 엉뚱한 대답을 하거나 확신을 하지 못하는 모습을 보였다.
원인을 찾고자 문서를 직접 찾아보았지만 명확하게 기록되어 있는 내용이었기에 자료에 문제는 아니라고 생각했다. 그럼 남은 원인은 모델이나 로직에 있다는 것이라 우선 모델을 더 좋을 것으로 바꿔보았다.
우리가 겪었던 질문 사례이다.
Q. 동아리장이 되려는 사용자가 카카오 OAuth로 최초 가입하면 처음 role은 뭐야?
→ 이상적인 정답: NORMAL
→ 잘못된 대답: NORMAL이나 MASTER가 될 수 있습니다.
모델을 바꾸어도 잘못된 대답을 하였다.
결국 우리는 로직에 문제가 있다고 판단하였고, 자세한 문제를 파악하기 시작했다.
검색 결과를 확인하기 위해 debug_retrieval.py라는 디버깅용 파일을 만들었고, 검색 과정 중간에 결과를 출력하도록 작성했다.
original:
동아리장이 되려는 사용자가 카카오로 최초 가입하면 처음 role은 뭐야?

--- rank 1 ---
score: ...
file: ...
<실제 chunk 내용>

--- rank 2 ---
score: ...
file: ...
<실제 chunk 내용>

...
과 같이 출력되는 결과를 보고 검색된 문서 랭크에 내가 원하는 내용이 존재하는지 살펴보았다.
결과는 꽤 유의미했는데, 프로젝트 내에서 쓰이는 권한(role)이 개념은 같지만 여러 곳에서 쓰이기 때문에 해당 단어를 포함하는 여러 문서가 더 앞선 랭크로 잡히는 것이었다. 즉, 우리는 ‘답변 생성의 문제보다는 Retrival, 검색에 문제가 있다’라고 원인을 확정지었다.
의미적 개선
이 문제를 해결하기 위해 우선 우리가 원하는 내용이 근사한 랭크에 들어와있는지부터 확인하였다.
Top-K를 이용하는 방식이기에 Top-2로 설정된 값이 10까지 늘려보았다.
역시나 이 안에 우리가 원하는 자료는 들어있지 않았다.
그렇다면 적어도 이 문제는 “Top-K가 작아서 발생한 문제”는 아니라는 결론이 세워진다. 물론 Top-K를 늘려서 해결되는 문제여도 안되기는 하다.
그럼 남은건 입력한 질문의 의미가 우리가 찾던 자료의 의미와 임베딩된 값이 많이 멀다는 것이다.
이 가정을 증명하기 위해 원래의 자연스러운 질문 대신, 원하는 문서에 매우 가까운 검색어를 넣어보았다.
Q. 최초 로그인 role NOMAL 일반 유저 자동 회원가입
이런식으로 최대한 의미적 유사도가 높을 수 있도록 질문해보았다.
그러자 아까는 보이지 않았던 정답 청크가 rank 2까지 올라왔다.
이 결과가 의미하는 바는 “질문 쿼리가 노이즈를 포함하고 있다”라고 보였다.
동아리장이 되려는 사용자가 카카오로 최초 가입하면 처음 role은 뭐야?
아까 보았던 이 질문을 사람의 입장에서 중요한 의미만 뽑아보면
카카오, 최초 가입, 초기 role이다.
하지만 벡터에서는 ‘동아리장’과 같은 값이 쿼리의 의미로 들어가 의도한 바와 다른 방향으로 흘러갈 수 있는 것이다.
이를 보완하기 위해 LLM을 사용한 Query Normalizer을 적용해보았다.
개념적으로는 단순히 모든 의미를 가진 쿼리를 생성하는 것이 아니라 LLM에세 검색에 사용할 핵심 키워드로 쿼리를 생성하는 것이다.
단순 규칙으로 처리하려면 너무 많은 표현을 처리해야 하기에 LLM을 이용하면 다음과 같이 통일해볼 수 있다.
카카오, 최초 가입, 초기 role
즉 자연어 표현의 다양성을 검색하기 좋은 형태로 정규화하는 역할을 한다.
물론, Query Normalization을 적용한다고 반드시 좋아지는 것은 아니기 때문에 이후 더 많은 테스트를 통해 개선해 나가야할 것이다.
마치며
가장 기본적인 RAG LLM을 만들어보았다.
확실히 프라이빗한 내용을 활용해 LLM을 사용하기 위해서 이거만한 방법은 없는거 같다.
하지만 AI의 다양한 활용법이 만연한 지금 과연 RAG의 활용도가 기대만큼 좋을지는 잘 모르겠다.
2026년 하반기인 지금, RAG라는 기술은 어쩌면 올드한 기술일 수도 있다고 생각한다.
보안적인 부분을 제외한다면, 이번 세션에서 노션이라는 플랫폼에서 데이터를 가져오는건 굳이 API를 활용하지 않아도 된다. 요즘 핫한 MCP를 사용해서 가져다가 바로 써도 괜찮은데, 왜 이걸 따로 임베딩 해놓고 써야하느냐는 확실히 해결해야할 문제이다.
그래도 기대하는 바를 말해보자면, 처리 속도를 기대해볼 수 있을 것 같다. 기존의 데이터를 미리 정제해서 빠르게 제공할 수 있다는 점이 첫번째 기대 효과이고, 두번째로는 업무와 관련된 자료는 한 곳에 통합해놓고 쓸 수 있다는 점이다.
기술은 어떻게 연결하고 활용하는가에 따라 그 활용도가 천차만별이라고 생각하기에, 앞으로 어떤 아이디어를 가지고 접근할 것인지를 많이 고민해봐야 할 듯 하다. 그리고 그럼에도 여전히 “왜 RAG인가?”라는 근본적인 질문에는 답하기 어려운 것도 사실이다.
그럼에도 계속해서 새로운 기술이 올라오는 시대에 사용해보는 것과 아닌 것에는 차이가 있다고 생각하기에 유의미하다고 생각한다. 조만간 RAG를 활용에 대해 고민해보고 정리해보겠다.